
Model, který schválně neumí mluvit. Jev vrací rozhodnutí místo textu, je 25krát rychlejší a 76krát levnější
TypeSafe AI vyšla ze stealth se 40 miliony dolarů a modelem Jev, který negeneruje ani jeden token textu. Místo toho vrátí typované rozhodnutí s pravděpodobností, a to za 0,4 sekundy a čtyři desetitisíciny dolaru na případ. Na přesnosti ale ztrácí na velké modely a jejich benchmark je potřeba číst pozorně. Rozebíráme, kdy tohle dává smysl a kdy ne.
Většina modelů, které dnes používáme, umí jedinou věc: generovat text token po tokenu. Když po nich chceme rozhodnutí typu "je tahle faktura v pořádku ano nebo ne", uděláme to tak, že jim do promptu napíšeme, ať odpoví JSONem, a pak doufáme, že se trefí do formátu. Platíme přitom za generování, čekáme na sekvenční dekódování a stejně musíme výstup validovat.
Startup TypeSafe AI včera vyšel ze stealth módu s tvrzením, že tohle je celé špatně postavené, a s modelem, který negeneruje ani jeden token textu.
Kdo za tím stojí
Firmu založil v roce 2024 Diogo Almeida, bývalý výzkumník OpenAI a spoluautor RLHF, tedy té techniky, na které stojí ChatGPT. S ním jsou spoluzakladatelé Erik Gafni a Sasha Sheng. Ze stealth módu vyšli s 40 miliony dolarů v seed kole, které vede DCVC.
Model se jmenuje Jev, což je odkaz na Jevonsův paradox: když něco zlevní, spotřeba toho naroste víc, než o kolik to zlevnilo. To je docela jasné vyjádření toho, co si od svého přístupu slibují.
Co je "System One Model"
TypeSafe tomu říká System One Model a je to narážka na Kahnemanovo dělení myšlení na rychlé intuitivní a pomalé uvažující. Chatovací modely dnes jedou spíš v režimu System Two, tedy uvažují nahlas a dlouho. Jev dělá to druhé.
Prakticky to funguje takhle:
- na vstup dostane strukturovaná data nebo přirozený jazyk
- vrátí typované rozhodnutí, tedy volbu z povolených možností, skóre nebo pravděpodobnost ano nebo ne
- udělá to v jednom paralelním průchodu, ne token po tokenu
- ke každé odpovědi přiloží rozdělení pravděpodobnosti, ne jen výsledek
- z jednoho promptu zvládne vrátit stovky rozhodnutí naráz
Trénovali ho metodou, které říkají RLCD, Reinforcement Learning for Calibrated Decisions. Neoptimalizuje se tedy na to, aby odpověď vypadala dobře, ale na kalibraci: když model řekne, že si je jistý na 70 procent, má mít pravdu v 70 procentech případů. To je vlastnost, kterou u chatovacích modelů notoricky nemáte a která se v produkci hrozně hodí, protože podle ní můžete rozhodnout, kdy smí software jednat sám a kdy má úlohu předat člověku.
Čísla, kvůli kterým to stojí za pozornost
Tady je ten rozdíl, který nejde přehlédnout. Na benchmarku, který TypeSafe pustila, vypadá srovnání s GPT-5.6 Terra takhle:
- latence 0,4 sekundy na případ proti 10,1 sekundy u Terry, tedy zhruba 25krát rychleji
- cena 0,0004 dolaru na případ proti 0,0304 dolaru, tedy asi 76krát levněji
- ceník je 0,042 dolaru za milion vstupních tokenů a nula za výstupní, protože žádný výstup se negeneruje
Celkově firma tvrdí, že na průměru napříč workflow je 193krát rychlejší a 444krát levnější než GPT-6 Astra a Fable 5.1. Koncová latence se podle nich pohybuje mezi 70 a 500 milisekundami.
Nejnázornější demo je Doom. Bot řízený Jevem hraje na základě textového popisu stavu hry, dělá zhruba 10 volání za sekundu a stojí to kolem 7 dolarů na hodinu. Na chatovacím modelu by tenhle režim nešel ani technicky, ani cenově.
A teď ta část, kterou marketing neříká nahlas
Jev je rychlý a levný. Chytřejší ale není. Nejlíp je to vidět na grafu, který TypeSafe sama zveřejnila:
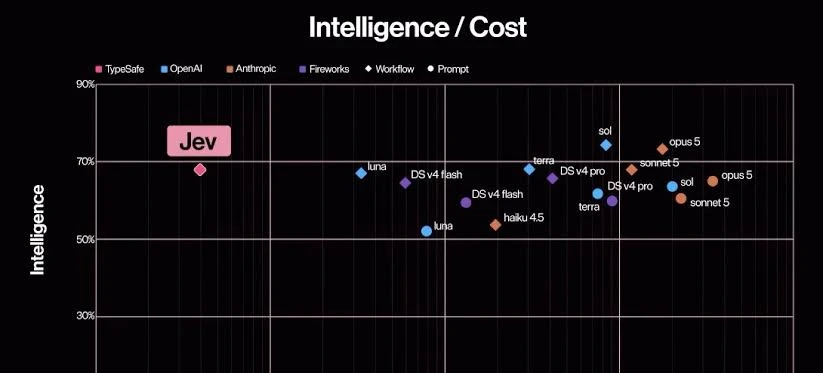
Jev je na té ose ceny osamocený úplně vlevo, což je přesně ta pointa. Zároveň je ale vidět, že na svislé ose ho sol i opus 5 převyšují. Konkrétní čísla napříč čtyřmi workflow vypadají takhle:
- Jev 67,8 procenta
- GPT-5.6 Sol 74,1 procenta
- Claude Opus 5 73,1 procenta
- GPT-5.6 Terra 67,9 procenta
Po jednotlivých úlohách je to ještě zajímavější. U zákaznického servisu je Jev na 76,0 proti 78,3 u Opusu 5, takže rozdíl je malý. U bezpečnostních incidentů 61,7 proti 66,2. Ale u zpracování faktur je to 61,8 proti 79,1, což už je propast, kterou v účetnictví nikdo nepřejde.
A důležitější je metodologická poznámka. Referenční odpovědi v tom benchmarku nejsou ověřená pravda, ale průměr toho, co odpověděly GPT-6 Astra a Fable 5.1. Měří se tedy shoda s jinými modely, ne správnost. Když TypeSafe říká, že Jev "nemůže halucinovat", platí to na formát: model fyzicky nemůže vrátit nic mimo povolené možnosti. Neplatí to na úsudek. Vybrat povolenou možnost a přitom se rozhodnout blbě jde úplně stejně dobře.
Co si z toho vzít
- Pro jednu třídu úloh je to správná odpověď. Klasifikace, routing, extrakce, přechody stavů, schvalování a eskalace. Tam všude dnes voláme chatovací model na něco, co je ve skutečnosti jedno rozhodnutí, a platíme za to generováním. Jestli takové volání děláte tisíckrát denně, rozdíl 76krát v ceně je rozdíl mezi projektem, který se zaplatí, a projektem, který ne. Psali jsme o tom v článku o optimalizaci na cost-per-task a tohle je přesně ten směr dotažený do krajnosti.
- Kalibrace je podceňovaná věc. Mít ke každému rozhodnutí poctivou pravděpodobnost je v produkci často cennější než pár procent přesnosti navíc. Umožňuje vám postavit hranici, pod kterou se úloha automaticky předá člověku, a tu hranici si můžete nastavit podle toho, kolik stojí chyba.
- Ale nenaskakujte na to plošně. U faktur ztrácí sedmnáct procentních bodů. Než něco takového nasadíte, potřebujete vlastní evaluaci na vlastních datech s vlastní ground truth, ne cizí benchmark postavený na shodě s jinými modely.
- Architektura zase jednou porazila škálování. Nejde o větší model, ale o jinak položenou otázku: co když ten výstup vůbec nemusí být text? Je to zdravá připomínka, že v tomhle oboru pořád existují místa, kde se dá udělat řádový skok bez nového datacentra.
Jev je zatím v early access pro vybrané vývojáře, takže si ho hned nezkusíte. Ale ten nápad stojí za zapamatování i bez přístupu. Až budete příště psát prompt, který končí větou "odpověz pouze JSONem", zkuste si položit otázku, jestli na tuhle práci vůbec potřebujete model, který umí mluvit. 🎯
Kurátorsky, na základě veřejných zdrojů a kontextu našeho stacku. Pokud najdeš nepřesnost nebo chceš k tématu reagovat, napiš nám a rádi to opravíme.
Související
Máte nápad?
Vytvořme ho spolu.
Napište nám pár vět o tom, co chcete postavit či vytvořit. Do dvou pracovních dnů se ozveme s první bezplatnou konzultací.