
Claude Haiku 5.5 je o 90 procent levnější a za stejnou cenu poráží GPT-6 Luna. Čtyři osvědčené triky z Haiku 4.5 ale přestanou fungovat
Rodina 5.5 je kompletní. Haiku 5.5 stojí 0,10 a 0,50 dolaru za milion tokenů, tedy desetinu předchůdce a přesně tolik co GPT-6 Luna, a ve všech zveřejněných testech je nad ní. Má milionový kontext, přemýšlí a podle Anthropicu je to jeho nejrychlejší model. Jenže teplota nula, předvyplněná odpověď, malý max_tokens i čtení první části odpovědi teď končí chybou nebo prázdným výsledkem. A v ceníku je jedna hranice, na kterou se snadno narazí.
Dva týdny po Opusu 5.5 a devět dní po Sonnetu 5.5 vydal Anthropic dnes Claude Haiku 5.5 a rodina 5.5 je tím kompletní. Sám ho popisuje jako nejlevnější, nejrychlejší a nejschopnější malý model, jaký kdy vydal.
U malých modelů se obvykle čte hlavně cena. Tady stojí za to číst i dokumentaci, protože ten skok proti Haiku 4.5 je tak velký, že se změnilo i to, jak se s modelem pracuje.
Desetina ceny
Haiku 5.5 stojí 0,10 dolaru za milion vstupních a 0,50 za milion výstupních tokenů. Haiku 4.5 stál 1 a 5. Je to tedy o 90 procent méně a zároveň přesně stejná cena jako u GPT-6 Luna. Čtení z cache vyjde na 0,01 dolaru.
Ta nízká cena ale platí jen pro požadavky do 100 tisíc tokenů. Nad touto hranicí se platí 0,50 a 2,50, tedy pětinásobek, i když pořád o polovinu méně než u Haiku 4.5. Podle Anthropicu se pod hranici vešlo zhruba 90 procent požadavků, které šly na Haiku 4.5, a v průměru tak bude provoz asi o 75 procent levnější.
Za stejnou cenu jako Luna, ale lepší
Anthropic v tabulce srovnává Haiku 5.5 s Haiku 4.5, s GPT-6 Luna, která stojí stejně, a pro orientaci se Sonnetem 5.5. Sloupce jsou Haiku 5.5 / Haiku 4.5 / GPT-6 Luna:
- GDPval-AA v2.1 (práce napříč profesemi): 1620 / 735 / 1437
- AA-Briefcase v1.1: 1578 / 614 / 1336
- OSWorld 2.1 (ovládání počítače): 72,4 / 15,7 / 48,9
- Terminal-Bench 4.0 (agentní programování): 39,2 / 0,0 / 16,4
- FrontierCode 1.1: 46,4 / nezveřejněno / 42,4
- Chartography (čtení grafů): 46,4 / 6,4 / 29,1
- Humanity's Last Exam s nástroji: 57,4 / 18,7 / nezveřejněno
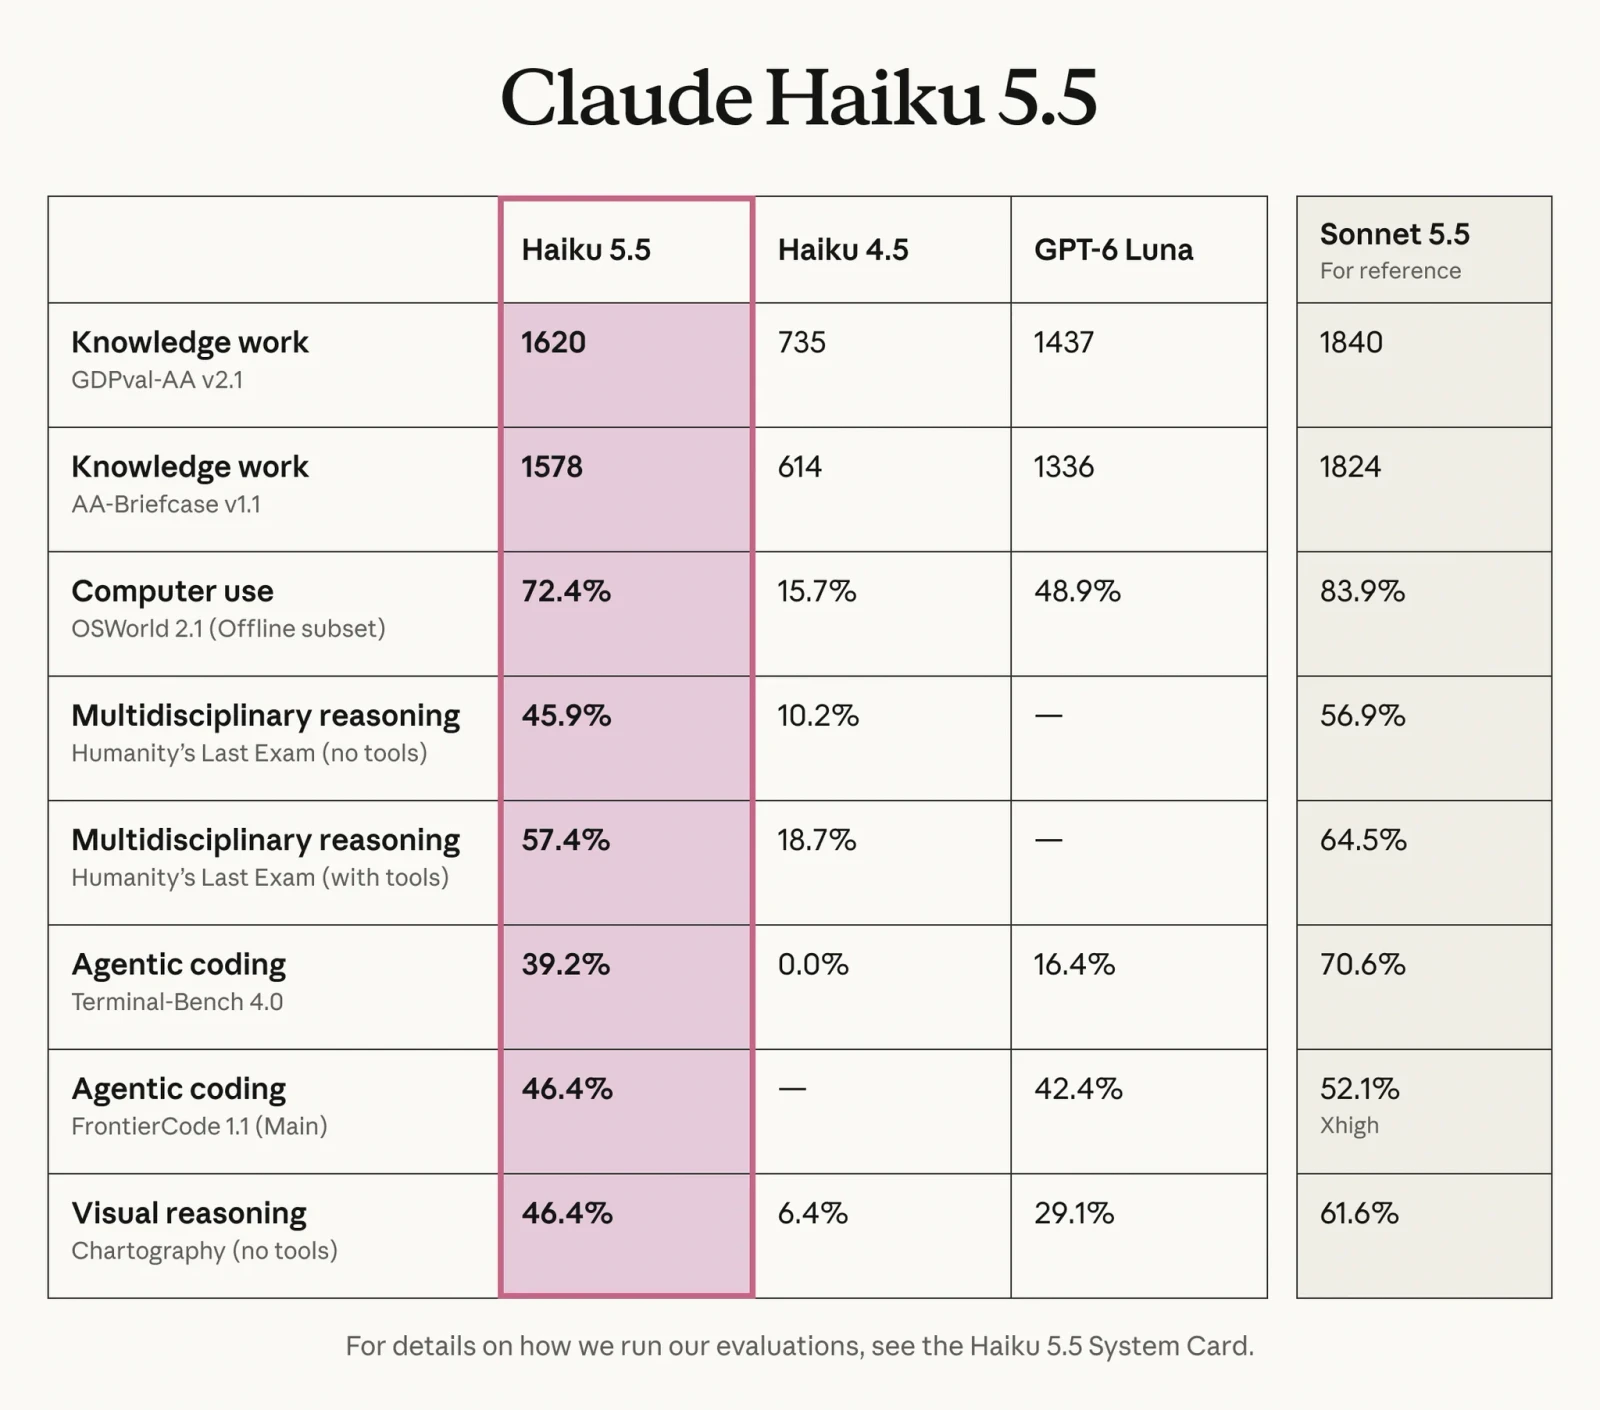
Proti předchůdci je to jiná kategorie, u ovládání počítače skok z 15,7 na 72,4 procenta. A proti Luně za stejné peníze vede ve všech řádcích, kde jsou čísla pro oba modely. Jen připomínáme, že tabulku sestavil Anthropic. Nezávislé srovnání zatím chybí.
Zajímavá jsou i čísla od firem, které ho zkoušely před vydáním. Asana hlásí přes 30 procent nižší zpoždění a až 2,5krát rychlejší krok agenta. Box poloviční zpoždění proti Haiku 4.5 a o 11 bodů lepší výsledek. A Cognition, firma za programovacím agentem Devin, ho používá jako pomocníka velkého modelu a drží s ním skóre 66,2 ve FrontierCode při nižší ceně i zpoždění.
Na co je a na co ne
Anthropic ho cílí na práci, kde rozhoduje objem a rychlost: shrnutí, zhušťování kontextu, dotazy do databáze, klasifikaci, živou zákaznickou podporu a ovládání prohlížeče. A hlavně jako podagenta vedle Opusu 5.5 nebo Sonnetu 5.5, který dostane menší úlohu a vrátí výsledek.
Zároveň výslovně píše, na co ho nedoporučuje: složité agentní programování. Tam je pořád potřeba Sonnet nebo Opus. To je férové upozornění a vyplatí se ho brát vážně. Těch 39 procent v Terminal-Benchi je proti nule u předchůdce obrovský skok, ale proti 70,6 u Sonnetu 5.5 pořád jiná liga.
Nové je i to, co má "malý" model v sobě: kontextové okno 1 milion tokenů (Haiku 4.5 měl 200 tisíc), výstup až 128 tisíc tokenů (dřív 64 tisíc) a adaptivní přemýšlení s nastavitelným effortem, jehož výchozí hodnota je medium.
Čtyři triky, které přestanou fungovat
Tohle je nejdůležitější část pro každého, kdo dnes Haiku 4.5 provozuje. Malé modely se roky nasazovaly s pár osvědčenými postupy, hlavně na klasifikaci a extrakci. Na Haiku 5.5 neprojde ani jeden z nich.
1. Teplota nula. Nastavit temperature: 0 bylo u klasifikace skoro reflex. Na Haiku 5.5 vrátí jakákoliv nevýchozí hodnota temperature, top_p nebo top_k chybu 400. Ty parametry musíte z požadavku úplně vyhodit.
2. Předvyplněná odpověď. Oblíbený trik, jak donutit model odpovědět čistým JSONem: začít jeho odpověď sami znakem {. Na Haiku 5.5 zpráva od asistenta na konci konverzace vrací chybu. Místo toho použijte strukturované výstupy.
3. Malý max_tokens. Na klasifikaci jste dřív klidně nastavili max_tokens na pár desítek, stačilo na jedno slovo. Jenže Haiku 5.5 ve výchozím stavu přemýšlí a tokeny za přemýšlení se do limitu počítají. Model tak může vyčerpat limit na přemýšlení a skončit dřív, než napíše odpověď. Nespadne nic, jen dostanete prázdný výsledek.
4. Čtení první části odpovědi. Spousta kódu bere odpověď jako "první blok obsahu". U Haiku 5.5 může odpověď začínat blokem s přemýšlením, jehož text je navíc ve výchozím stavu prázdný. Bloky je tedy potřeba vybírat podle jejich typu, ne podle pořadí.
Přemýšlení se dá vypnout, jen pokud effort nepřekročí high. Pro klasifikaci to je asi nejjednodušší cesta, jak se vyhnout bodům 3 a 4. Ale pokud tohle všechno dnes v kódu máte, výměna ID modelu vám nestačí.
Past v ceníku, kterou nikdo nezmiňuje
Haiku 5.5 používá novější tokenizér, stejný jako modely od Claude 4.7 výš. Podle dokumentace z téhož textu udělá přibližně o 30 procent víc tokenů než Haiku 4.5. Přesné číslo záleží na obsahu.
Teď si to dejte dohromady s tou hranicí 100 tisíc tokenů. Prompt, který měl na Haiku 4.5 zhruba 77 tisíc tokenů, bude na Haiku 5.5 přes 100 tisíc a spadne do pětkrát dražšího pásma. Pořád to vyjde levněji než Haiku 4.5, ale výrazně dráž, než by člověk čekal z titulku o "devadesáti procentech".
Nejvíc to dopadne na ty, kdo do malého modelu posílají dlouhé dokumenty nebo velké kusy kontextu. A ten milionový kontext k tomu přímo svádí. Pokud vám jde o cenu, držte velikost požadavků pod hranicí a velké věci krájejte, nebo je pošlete Sonnetu. Je to přesně případ, kdy se vyplatí počítat náklady na úlohu, ne cenu za token.
A dvě novinky navíc
S Haiku přišly dvě věci, které se týkají i ostatních.
Sonnet 5.5 zlevnil čtení z cache na polovinu, z 0,20 na 0,10 dolaru. Podle Anthropicu to dělá Sonnet zhruba o pětinu levnějším na většině agentní práce.
A předplatitelé Max a Team dostanou každý měsíc kredit na API: 100 dolarů u Max 5x, 200 u Max 20x a u Team až 500 dolarů společně. Po tom, co jsme minulý týden psali o tom, jak OpenAI na DevDayi snížila objem předplatného Pro a jak Anthropic v září obratně prodal škrt v Claude Code jako navýšení, je tohle změna tím správným směrem. Uvidíme, jak dlouho vydrží.
Co si z toho vzít
- Malé modely už nejsou "horší verze". V tabulce Anthropicu má Haiku 5.5 ve znalostní práci i ovládání počítače mnohem blíž k Sonnetu 5.5 než ke svému předchůdci. Projděte si úlohy, které dnes posíláte Sonnetu jen ze zvyku, a zkuste je dát Haiku.
- Na klasifikaci teď existují tři přístupy. Jev od TypeSafe, který nepíše text, ale rovnou rozhoduje. Decisions API od OpenAI. A obyčejný, ale velmi levný Haiku 5.5. Za měsíc tři odpovědi na stejný problém. Změřte si je na svých datech.
- Před přechodem si projděte kód, ne jen ceník. Teplota, předvyplněná odpověď, malý
max_tokensa čtení první části odpovědi. Pokud máte aspoň jedno z toho, přechod vám něco rozbije, a dvě z těch věcí to udělají potichu. - Hlídejte si hranici 100 tisíc tokenů. S těžším tokenizérem na ni narazíte dřív, než čekáte.
Rodina 5.5 je hotová za patnáct dní: Opus, Sonnet a teď Haiku, všechny levnější než předchůdci. Haiku je z nich nejméně okázalý a možná nejvíc změní účty. Většina AI provozu ve firmách totiž nejsou chytré rozhovory, ale miliony malých rozhodnutí. A ta teď stojí desetinu. 🍃
Kurátorsky, na základě veřejných zdrojů a kontextu našeho stacku. Pokud najdeš nepřesnost nebo chceš k tématu reagovat, napiš nám a rádi to opravíme.
Související
Máte nápad?
Vytvořme ho spolu.
Napište nám pár vět o tom, co chcete postavit či vytvořit. Do dvou pracovních dnů se ozveme s první bezplatnou konzultací.