
Gemini 4 Argon: Google se vrací mezi tři nejlepší, ale nevyhrává. Jeho nejzajímavější číslo přitom v žádném titulku není
Google přeskočil Gemini 3.5 Pro a vydal rovnou Gemini 4 Argon. Ve vlastních testech porazí Astru i Opus 5.5, v nezávislém měření se Astře jen vyrovná a na Opus 5.5 ztrácí. Zázrak to opravdu není. Jenže si vymýšlí ve 15 procentech případů, kde konkurence ve více než polovině, a to je pro firmy možná důležitější než celé pořadí. Jen si ho zatím skoro nikdo nevyzkouší.
V létě jsme psali o Gemini 3.6 Flash a záhadě chybějícího 3.5 Pro. Teď máme odpověď. Gemini 3.5 Pro nevyjde nikdy. Google ho přeskočil a včera představil rovnou Gemini 4 Argon.
Kolem vydání se rychle ujal názor, že to "není žádný zázrak jako Fable, Astra nebo nový Opus". Je na tom kus pravdy. Ale jen kus, a ten zbytek je zajímavější.
Proč to trvalo tak dlouho
Kontext je důležitý, protože vysvětluje, proč Google na tohle vydání tolik spoléhá. Gemini 3.5 Pro mělo vyjít v červnu, interně se odkládalo kvůli výkonu a nakonec se zrušilo úplně. Podle Axiosu za zdržením byla i špatná nálada v týmu.
V srpnu pak přišla velká změna ve vedení. Demis Hassabis odstoupil z pozice šéfa DeepMindu, zůstal předsedou a stal se hlavním vědcem Alphabetu. DeepMind teď vede dosavadní technický ředitel Koray Kavukcuoglu, který se zodpovídá přímo Sundaru Pichaiovi. Ve stejný den oznámil odchod do vlastního startupu Jeff Dean a ještě dřív odešel nobelista John Jumper do Anthropicu.
Argon je tedy první velký model nového vedení. A podle toho je postavený: méně vize, víc praktické práce.
Na co je
Google ho cílí na dlouhou profesionální práci: vývoj softwaru, firemní rešerše, právní a finanční procesy a obrannou kybernetickou bezpečnost. Kontextové okno má milion tokenů a podle Googlu umí nově vygenerovat i až milion tokenů výstupu, předchozí generace zvládla 64 tisíc. To je novinka, která se hodí přesně na dlouhé dokumenty, rozsáhlé úpravy kódu nebo celé právní podání najednou.
Čí čísla čtete
Tady je ten důvod, proč se jedni radují a druzí krčí rameny. Záleží, kdo měří.
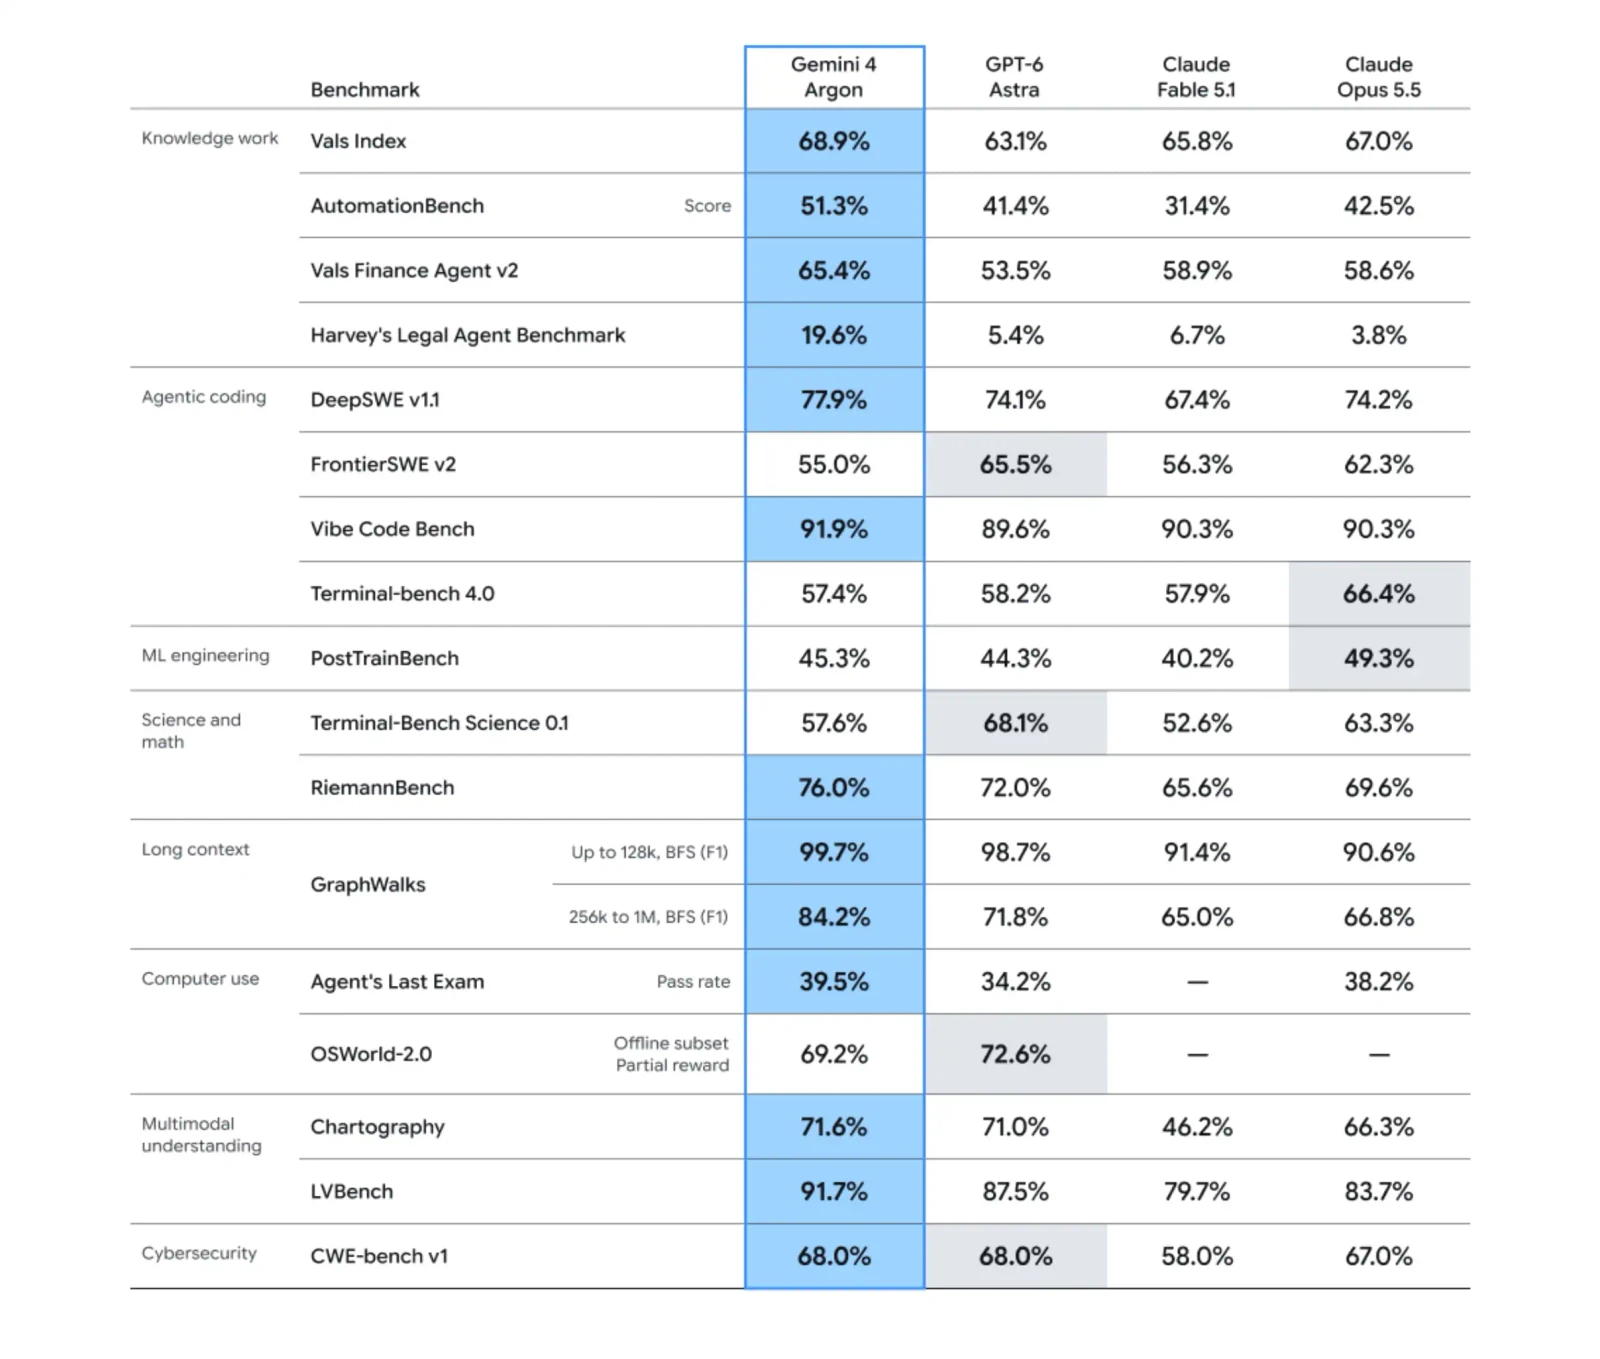
Podle Googlu Argon porazí GPT-6 Astra, Claude Fable 5.1 i Claude Opus 5.5 na většině testů, které firma zveřejnila. Pár konkrétních:
- AutomationBench: 51,3 procenta, proti 42,5 u Opusu 5.5 a 41,4 u Astry
- DeepSWE v1.1: 77,9 procenta, proti 74,2 u Opusu 5.5 a 74,1 u Astry
- Právní agenti od Harvey: 19,6 procenta, zatímco ostatní tři mají 3,8 až 6,7. Čísla jsou nízká u všech, ale u práva je to rozdíl, který je vidět.
- Dlouhý kontext (GraphWalks, 256 tisíc až milion tokenů): 84,2 procenta, proti 71,8 u Astry a 66,8 u Opusu 5.5
Ve stejné tabulce je ale vidět i to, kde Argon nevede. Astra je výš ve FrontierSWE v2 (65,5 proti 55,0), v Terminal-Bench Science (68,1 proti 57,6) a v ovládání počítače na OSWorld 2.0 (72,6 proti 69,2). Opus 5.5 vede v Terminal-Benchi 4.0 (66,4 proti 57,4) a v PostTrainBench (49,3 proti 45,3). A pamatujte, že tuhle tabulku sestavil Google, takže si vybíral i to, které testy v ní budou.
Podle nezávislých měření je obraz střízlivější:
- Artificial Analysis Intelligence Index: Argon 53, GPT-6 Astra 53, GPT-6.1 Sol 52. A Claude Opus 5.5 zhruba o pět bodů výš.
- Vals Index: tady je Argon naopak první ze 41 modelů s 68,9 procenta, před Sonnetem 5.5 se 67,0, Opusem 5.5 s 67,0 a Fable 5.1 s 65,8.
Takže závěr: Google je zpátky mezi třemi nejlepšími laboratořemi, ale jasně nevede. Podle toho, jaký test zvolíte, je první, nebo třetí. To je přesně to, co lidé myslí tím "není to zázrak". Po tak dlouhém čekání a výměně vedení by člověk čekal jasnější výhru.
Číslo, které je důležitější než pořadí
Artificial Analysis měří i to, jak často si model vymyslí odpověď místo toho, aby přiznal, že neví. A tady se Argon od ostatních odtrhl:
- Gemini 4 Argon: 15 procent
- GPT-6 Astra: 51 procent
- GPT-6.1 Sol: 54 procent
Je to nejnižší míra vymýšlení u všech modelů, které v jejich indexu inteligence dosáhly aspoň 45 bodů. Astra a Sol si podle tohohle měření vymyslí odpověď ve více než polovině případů, kdy by měly říct "nevím". Argon v necelé šestině.
Pro firmy je tohle podle nás podstatnější než to, jestli model vyhraje o bod nebo dva prohraje. V právu, financích nebo rešerších neplatíte za model, který je o kousek chytřejší. Platíte za model, kterému můžete věřit, že vás nebude sebevědomě klamat. Pokud se ta čísla potvrdí i v praxi, je to důvod Argon zkoušet právě na tyhle úlohy, i kdyby v žebříčku skončil třetí.
Háček číslo jedna: upovídanost a zaváděcí cena
Na první pohled je Argon i levný. 2 dolary za milion vstupních a 10 za milion výstupních tokenů, tedy stejně jako GPT-6.1 Sol a polovina Opusu 5.5. Za jednu úlohu v testu Artificial Analysis vyjde na zhruba 2 dolary, proti 3,26 u Astry a 5,98 u Opusu 5.5.
Ale pozor na dvě věci:
- Je to zaváděcí cena. Po skončení akce se vrací na 4 a 20 dolarů, tedy dvojnásobek.
- Argon je upovídaný. Na jednu úlohu vygeneruje v průměru 62 tisíc tokenů, Astra 27 tisíc. Tedy víc než dvojnásobek.
Když to dáte dohromady, za plnou cenu vyjde Argon na úlohu podle našeho přepočtu zhruba o pětinu dráž než Astra, ne levněji. Ta cenová výhoda je tedy dočasná. Přesně kvůli tomu jsme psali o počítání nákladů za úlohu místo za token. Cena za milion tokenů vám u upovídaného modelu řekne jen polovinu příběhu.
Háček číslo dvě: zatím si ho nevyzkoušíte
Tohle je asi nejvíc frustrující část. Argon zatím není běžně dostupný. Při oznámení ho dostali jen prověření obránci v kybernetické bezpečnosti v rámci programu Fairwind a interní týmy Googlu. Model navíc prochází dobrovolnou kontrolou americké vlády před vydáním.
Běžný přístup přijde "později", nejdřív pro platící zákazníky API a předplatitele Google AI Ultra. Datum Google neuvedl, není ani pořadník, ani zveřejněné ID modelu pro API.
Dá se to číst dvojím způsobem. Buď opatrnost, která po měsíci, kdy OpenAI dvakrát zastavila trénování kvůli agentům, dává smysl. Nebo potřeba oznámit model co nejdřív, aby Google v říjnu nezůstal úplně mimo hru, i když ještě není připravený pro všechny. Pravděpodobně trochu obojí.
Co si z toho vzít
- Google je zpátky ve hře. Po roce, kdy se o něm v souvislosti se špičkovými modely mluvilo spíš kvůli zpožděním, má zase model na úrovni nejlepších. Pro trh je to dobře, tři silní hráči tlačí na cenu víc než dva.
- Míra vymýšlení je nová disciplína, kterou stojí za to sledovat. U úloh, kde je chyba drahá, je model, který přizná nejistotu, cennější než model, který je o kousek chytřejší. Tohle číslo hledejte u každého dalšího vydání.
- Nenechte se nachytat zaváděcí cenou. Kdo si dnes spočítá rozpočet podle 2 a 10 dolarů a nezapočítá dvojnásobnou upovídanost, bude za pár měsíců překvapený.
- A zatím nic neměňte. Dokud Argon není dostupný, nemá smysl kvůli němu přestavovat cokoliv. Až bude, vyzkoušejte ho nejdřív tam, kde vám dnes nejvíc vadí vymyšlené odpovědi.
Takže ano, zázrak jako Astra nebo nový Opus to není. Ale je to první model za dlouhou dobu, který místo "jsem chytřejší" říká "vymýšlím si méně". A to je podle nás přesně směr, který firmy potřebují víc. 🔷
Kurátorsky, na základě veřejných zdrojů a kontextu našeho stacku. Pokud najdeš nepřesnost nebo chceš k tématu reagovat, napiš nám a rádi to opravíme.
Související
Máte nápad?
Vytvořme ho spolu.
Napište nám pár vět o tom, co chcete postavit či vytvořit. Do dvou pracovních dnů se ozveme s první bezplatnou konzultací.